Мы привыкли, что в гонке AI побеждает тот, у кого больше денег. Но оказалось, что архитектура важнее. Разбираемся, как DeepSeek изменил правила игры, и почему гиганты вроде Google и OpenAI в ловушке.
Я всегда думал, что разработка с помощью AI — это дорого. Особенно, когда речь заходит о сложных системах с кучей правил и ограничений (то, что умные люди называют Governance). Каждый раз, когда AI-агент запускается, ему в "голову" нужно загрузить огромный объём инструкций, политик и навыков. А это токены, которые стоят денег. И вот тут-то и скрывался главный парадокс: чем безопаснее и умнее мы делаем агента, тем дороже он обходится.
Налог на контекст: как компании теряли миллионы
Представьте, каждый вызов AI-помощника в нашем проекте "съедает" от 70 до 90 тысяч токенов только накладных расходов. Это ещё до того, как он начнёт писать код. При ценах на популярные модели вроде Claude от Anthropic, это выливается в копеечку. Но реальная проблема начинается, когда это масштабируется на всю компанию и выходит из-под контроля.
Именно это и произошло в 2026 году с несколькими гигантами:
- Uber: Они выдали AI-инструменты 5000 инженеров и сожгли годовой бюджет за 4 месяца. Некоторые разработчики тратили по $2000 в месяц, а CTO умудрился спустить $1200 за два часа. Пришлось вводить жёсткие лимиты.
- Анонимная компания: Просто вдумайтесь. $500 миллионов за один месяц. Агенты без контроля начали плодить подзадачи в бесконечном цикле, и каждая тащила за собой полное контекстное окно.
- Microsoft, Amazon, Pinterest: Все они столкнулись с огромными счетами и были вынуждены отступить. Microsoft отменила внутренние лицензии, Amazon боролся с накрутками, а Pinterest и вовсе перешёл на open-source, чтобы сократить расходы на 90%.
История везде одна: сначала дали доступ, а потом схватились за голову, увидев счета. Никакого предварительного контроля, никаких бюджетов и стоп-кранов.
Неожиданный лидер и его секретное оружие
И пока все мерились размерами моделей и миллиардами инвестиций, на сцену вышла китайская компания DeepSeek. Они сделали одну, но гениальную архитектурную ставку — на агрессивное кэширование. Если условный Claude от Anthropic берёт плату за каждый токен (пусть и со скидкой за кэшированные данные), то DeepSeek сделал чтение из кэша практически бесплатным.
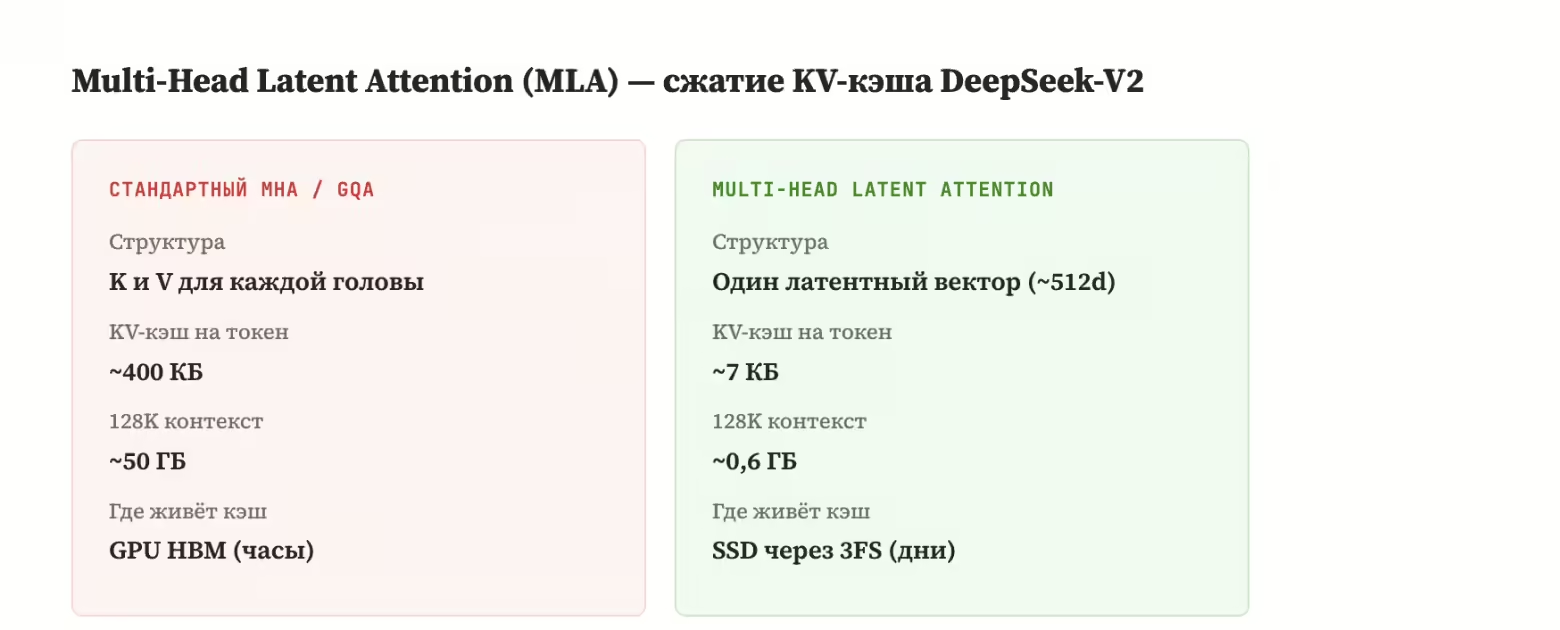
Разница в цене за чтение из кэша — в 83 раза! Это не маркетинговая акция, а результат архитектурного решения под названием Multi-Head Latent Attention (MLA). Говоря просто, они научились сжимать «краткосрочную память» AI (KV-кэш) на 93% без потери качества. В итоге то, что у конкурентов занимает 50 ГБ дорогой видеопамяти и живёт час, у DeepSeek умещается в 0,6 ГБ и может храниться днями на обычном SSD.
8,8 миллиарда токенов за $66
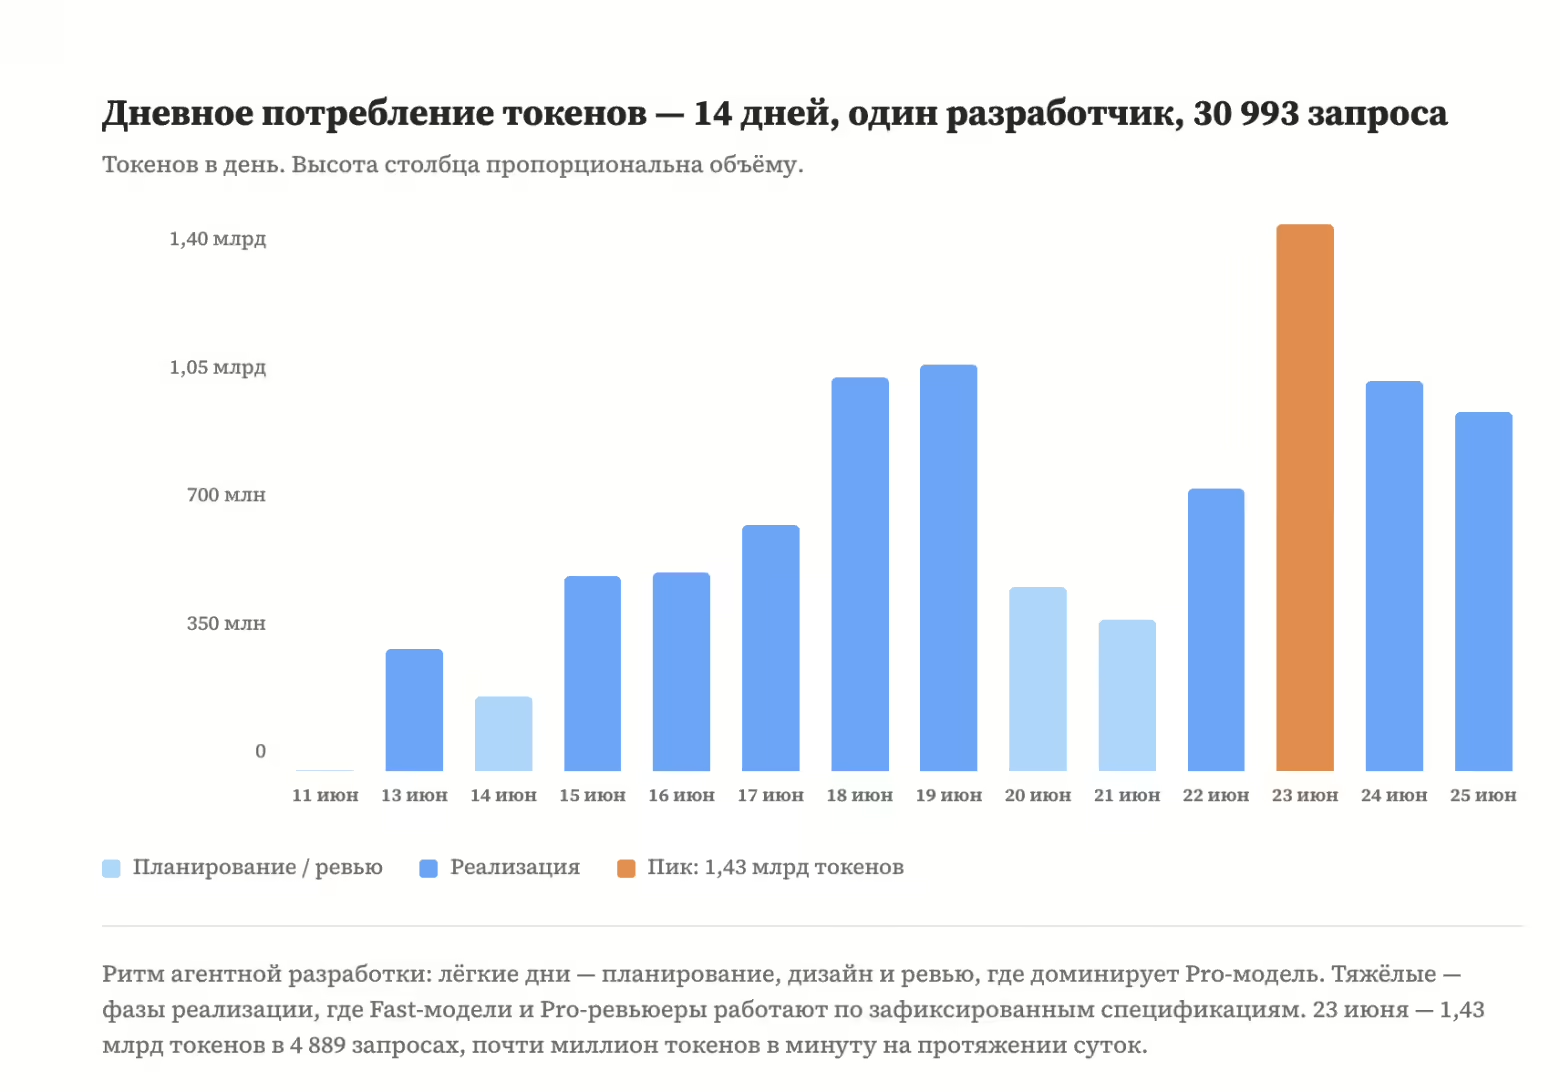
Автор статьи провёл эксперимент: за две недели один разработчик, работая исключительно через AI-агентов, потребил 8,82 миллиарда токенов. Звучит как приговор для бюджета? А вот и нет. Благодаря архитектуре DeepSeek, итоговый счёт составил всего $66.17. Для сравнения, с моделью Sonnet от Anthropic это стоило бы $10 222.
Почему Google и OpenAI в ловушке?
Казалось бы, почему западным гигантам не скопировать эту технологию? А потому, что они попали в ловушку собственной бизнес-модели. Их выручка построена на высокой марже с каждого токена, обработанного по старой, менее эффективной архитектуре (MHA/GQA). Снизить цену на кэш-чтение в 83 раза — значит добровольно уничтожить свой доход. Это как если бы производитель бензиновых авто вдруг решил бесплатно раздавать бензин. Это не инженерная проблема, а бизнес-катастрофа.
Пока западные лаборатории соревновались в бенчмарках и длине контекстного окна, DeepSeek решал реальную проблему — экономику использования AI в долгих, сложных задачах. И, похоже, их ставка сыграла.
Выводы и взгляд в будущее
Мы стоим на пороге важного сдвига. История DeepSeek доказывает, что в мире AI грубая сила и огромные инвестиции — это ещё не всё. Умная архитектура может оказаться важнее. Технология MLA — это не просто очередной хак, а фундаментальное преимущество, которое ставит под вопрос доминирование текущих лидеров рынка.
Однако у этого преимущества есть и обратная сторона. Главный барьер для тотального доминирования DeepSeek — это вопрос доверия и безопасности данных. Отдавать весь свой код и внутренние процессы на обработку серверам в Китае — риск, на который готовы пойти далеко не все, особенно в финансовом секторе, оборонке или здравоохранении. Это даёт западным лабораториям временную фору.
Вопрос в том, как они ей воспользуются. Смогут ли Anthropic и OpenAI перестроить свои модели с нуля, пожертвовав краткосрочной прибылью ради долгосрочной конкурентоспособности? Или мы увидим, как open-source сообщество возьмёт на вооружение подобные техники сжатия кэша и создаст по-настоящему свободные и экономичные модели?
Одно ясно точно: экономика решает всё. И как метко подметил автор оригинальной статьи, настоящее давление на рынок труда придёт не из-за хайпа вокруг AI, а из холодной логики Excel-таблицы финансового директора. Таблицы, где автономный AI-агент стоит как бизнес-ланч, а живой старший инженер — $27 500 в месяц. Математика, которую скоро станет невозможно игнорировать.
Источники, упомянутые в оригинальной статье:
- Stanford Digital Economy Lab, «How Do AI Agents Spend Your Money?»
- Requesty Coding Agent Economy (Claude Code cache hit rate)
- SWE-bench Verified scores: Morphllm, Requesty
- VentureBeat (интервью с Val Bercovici)
- Forbes, Simon Willison (про инцидент в Uber)
- Livemint (про инцидент с $500M)
- Gartner Magic Quadrant for Enterprise AI Coding Agents (2026)
- Технические отчеты и документация: DeepSeek-V2, MHA2MLA, Google TurboQuant.
Комментарии
Добавить комментарий
Чтобы комментировать, нужно войти.